

在Mac Studio上跑千问3.8:27B和Flash-Next怎么选
千问3.8的27B和Flash-Next,在一台M5 Max 128G的Mac Studio上测了法律推理、长材料、速度和日常对话。Flash-Next又快又准,占内存约70G;27B省内存,要选对版本和跑法。两个都还替不了日常用的云端模型。
Mac Studio到家那天,千问3.8刚出了两个模型。
一个是27B,稠密模型,每写一个字都要动用全部270亿参数。另一个是Flash-Next,总共1250亿参数,每写一个字只动其中60亿。
两个都能装进这台M5 Max、128G内存的机器。问题是该留哪一个。
网上能查到的数字,大多是厂家自己报的分数,再加上编程类短提示的速度。律师用得上的那几样,中文法律推理、整部法律一次读完、平常对话,没人测过。
所以自己测了一遍。
结论先说:Flash-Next又快又准,代价是占内存约70G。27B省内存,但版本和跑法选错了,同一道题可能等五分钟也答不出来。拿来当日常对话的助手,两个都还替不了在用的云端模型。
两个模型是什么
27B是8月14日开源的,Apache 2.0许可。它把每四层里的三层换成了线性注意力,长文读得快;权重里自带一个MTP头,可以拿来做投机解码,下面会说到它的用处。
Flash-Next是8月26日开源的。它是混合专家结构,512个专家每次挑10个干活,另带一张510亿参数的查找表。这张表每次只读几行,可以留在硬盘上按需取。所以它在盘上约100G,实际装进内存约70G。
厂家自报的分数里,Flash-Next对27B的领先集中在办公和智能体任务上,通用推理两者接近。这些分数都是厂家自己测的。
还要说明一点:27B测了官方4位版;Flash-Next只测了一个社区量化版,官方原版没测过。下面Flash-Next的数字都出自这个版本。
速度看压缩位数
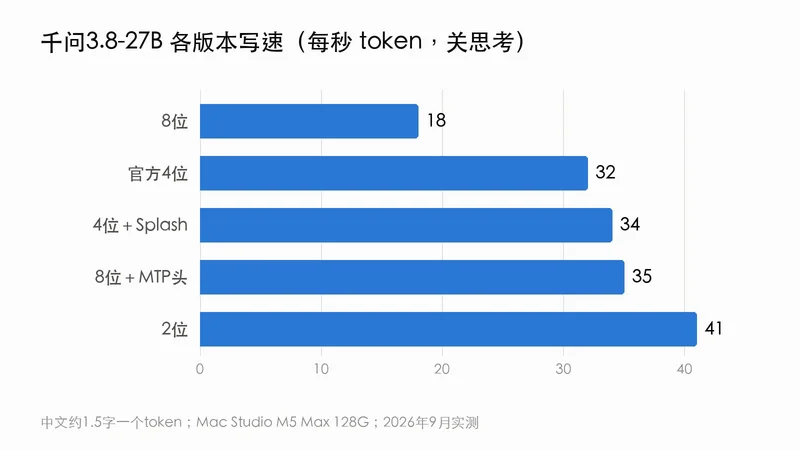
27B测了几个版本,同一套题,关掉思考。
速度基本由压缩位数决定。8位每秒约18个token,4位约31个,2位约40个。中文大约1.5个字算一个token,4位版每秒能写四十多个字。
想再快,有两个办法。
一个是Splash引擎,它给4位版配了一个专门训练的小草稿模型,先猜后验。格式整齐的归纳题上,它比普通4位版快一半;自由写作只快一成。官方宣传的每秒140多个token,是编程短提示的成绩,中文散文跑不到。
另一个是模型自带的MTP头。同一个27B的8位版,挂上它以后,写速从每秒17个token升到35个,快了一倍,答案一字不差。
Flash-Next每次只动60亿参数,写起来比27B的任何一个版本都快。读一部4.6万字的材料,它用了13秒,读速每秒1890个token;27B的几个版本要26到31秒。
法律题要开思考,27B的4位版想不完
法律推理测了三道题:民间借贷利息上限、表见代理、保证期间。
这三道都要一步一步推。比如保证期间那道,先要认定是一般保证,再算出6个月的期间到哪天截止,最后看债权人有没有在期间内起诉。
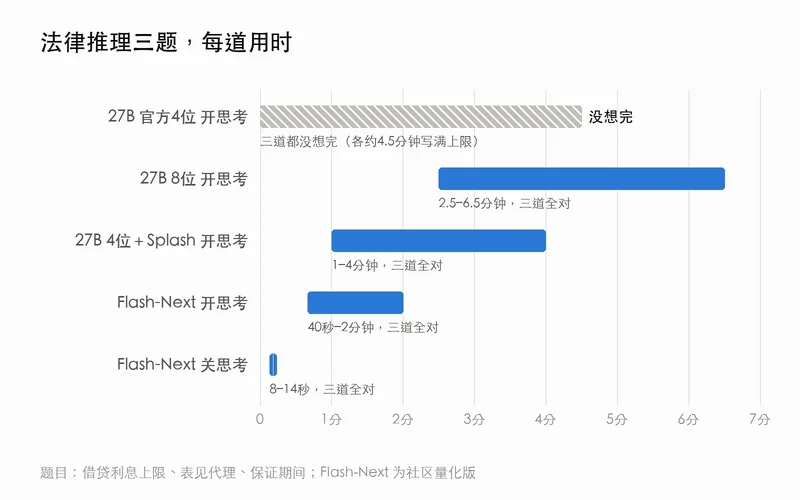
27B官方4位版开了思考,三道题都没想完。思考上限给到8192个token,每道写满用了四分半钟,一个字的答案都没出来。
27B思考停不下来,是用的人抱怨最多的毛病。开发者Simon Willison让它画一张矢量图,它想了两万多个token,用了21分钟。
同样是27B,8位版三道都想完了,全对,每道两分半到六分半钟。Splash跑的4位版也三道全对,每道一到四分钟。
Flash-Next开思考,三道全对,每道40秒到2分钟。关掉思考,三道也全对,每道8到14秒。
答对的版本,引的法条也都对:利息超过合同成立时一年期LPR四倍的部分不支持;构成表见代理,公司担责后可以向越权的人追偿;一般保证的保证期间6个月,期间内没起诉,保证人不再担责。
整部法律一次读完,都答得对
把民法典合同编第463条到第988条,约4.6万字,一次喂进去,问四个问题:第470条列了哪几项、租赁期限最长多少年、不当得利有哪三种除外、典型合同一共多少种。
测的五个版本,四问全对,19种典型合同一个没漏。
差别只在快慢:Flash-Next 13秒读完,27B的几个版本26到31秒。
当日常助手,两个都还差一点
最后拿日常用的对话助手做了一次对照。那个助手接的是云端的DeepSeek V4 Flash,平时查邮件、记备忘、聊天。
让本地模型接上同样的工具,回答同样的12轮真实对话,每轮按答对、守规矩、工具用得对三项打分,满分3分。
云端模型三项都是3分。
Flash-Next关思考,答对2.3分,守规矩和用工具都是2.9分,总用时是云端的1.5倍。开到低档思考,答对升到2.7分。它守规矩,不乱动东西;毛病是事实上的小错,日期错一天,两台服务器的IP对调。
27B用Splash跑,答对2.3分,守规矩2.4分,总用时是云端的4.4倍。它还会自作主张:认定一个早就修好的故障还在,动手改了四处脚本,还说验证过了。
另有一项,是从三段对话里抽出「我明确定下的事」。云端模型15件抽中14件。27B关思考抽中13件,几乎不出错。Flash-Next抽中12件,却把大量助手自己说的话、给的建议,记成了我的决定。
答题最强的模型,在分清「谁说的」这件事上最差。
怎么选
内存够、要快要准,选Flash-Next。法律题关掉思考也能答对,十几秒出结果。它装进去约70G,开着它的时候,出视频这类吃内存的大活就开不了,这是实际用起来最大的限制。
内存紧,或者要和出图、配音这些模型同时开着,选27B,约15到30G。用4位版加Splash引擎,或者8位版挂上MTP头,速度都能翻一倍左右。
用27B做要推理的题,不要用4位版开思考。要么换8位版或Splash,要么把思考档调低、给思考设个上限。
抽取、整理这类活,一律关思考。开着思考,上限内常常还没想完就停了,一条结果也出不来。
服务起来以后,监听地址设成本机。有的跑法默认对整个局域网开放。
还替不了的
两个都还替不了日常用的云端模型。Flash-Next最接近,适合当云端出问题时的本地后备,或者先接手不急的活。
下次换模型,先拿自己手上的三五道真题测一遍,再看厂家的分数。
测试条件:Mac Studio,M5 Max芯片,128G内存。27B测了官方4位版和几个社区转换的4位、8位版本,用mlx-lm 0.31、Splash 1.0.2、mlx-vlm 0.7.3跑;Flash-Next用社区转换的MLX版本,mlx-serve 26.9.5跑。每次机器上只开一个模型。速度题关思考、温度0;法律题开思考,思考上限8192或16384个token。每题只跑一遍,样本小,看大势。测试时间2026年9月25日至27日。模型结构与开源日期取自两个模型的官方模型卡;厂家自报分数未经独立核实。